Portfolio · AI Platform PM

Sylvia Zhong AI 平台产品经理 · Agent 编排与 AI 开发工具链

不是「用过 AI 的产品经理」,而是亲手把 Agent 编排、模型推理、上下文与记忆机制跑起来的产品经理。 独立设计并上线 6 Agent 协作流水线、自训练 16 型人格交互模型、一个对外开放的 API 平台, 外加 13 个线上产品——能把技术边界翻译成产品方案,也能自己验证它跑不跑得通。

联系方式
sylviacccyu@gmail.com
中国 · 深圳 | 开放全职与项目合作
6Agent 协作流水线
1对外开放 API 平台
13线上产品与站点
2已上线小程序
01 — SELECTED WORK

核心案例

五个最能代表我能力的项目,按「背景 → 做法 → 关键问题 → 结果」展开。

Agent 编排 · 平台型产品

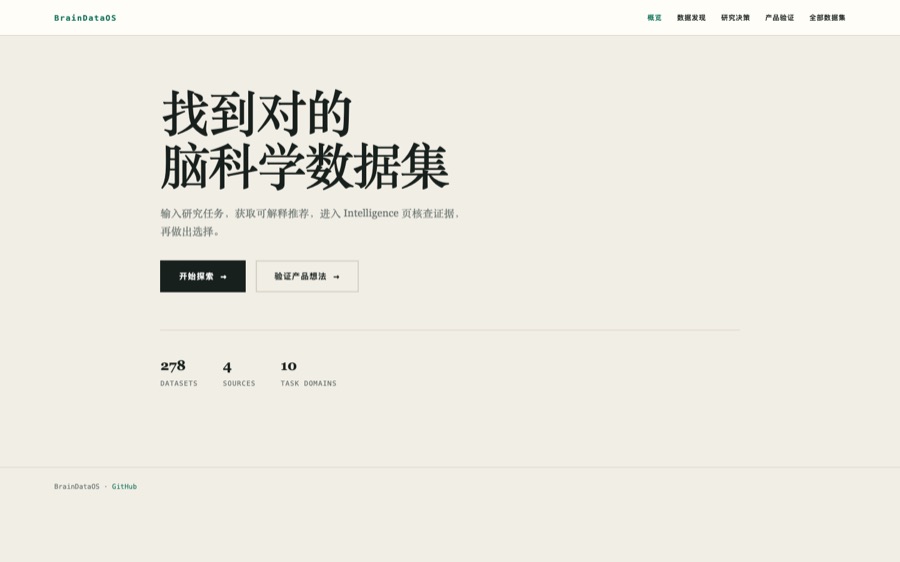
BrainDataOS · 6 Agent 协作的数据智能平台

brainos.bigmonsterclaw.com
● 在线
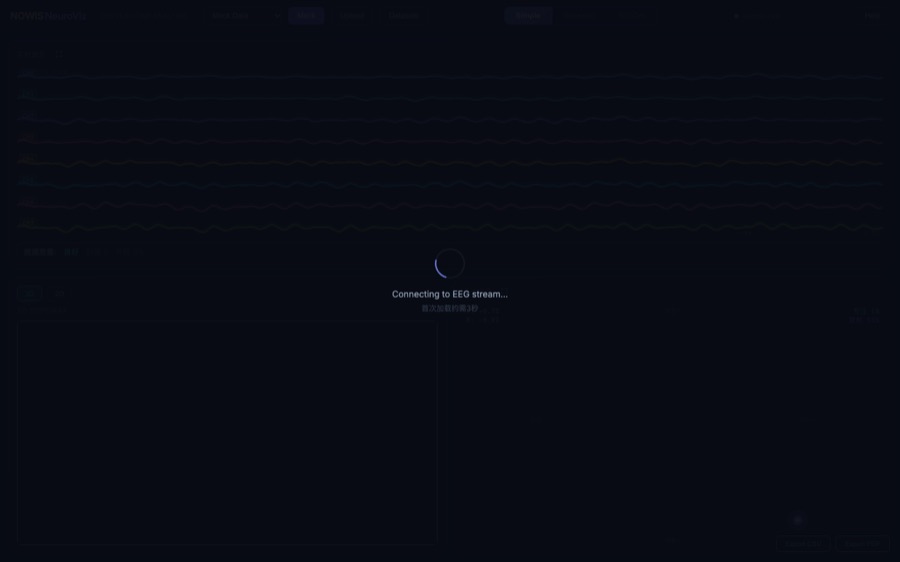
BrainDataOS 产品界面截图
背景

脑电研究数据散落在论文、公开数据集与实验室原始文件里,格式不统一、标签缺失。研究人员要花大量时间做「把数据洗干净」这种没有产出的工作。

我做了什么

把这条链路拆成 6 个职责单一的 Agent:论文爬取、数据标准化、标签抽取、模型 Benchmark、证据汇聚、决策输出。每个 Agent 只做一件事,通过明确的输入输出契约串成流水线,并做成可检索的数据发现界面。

关键问题与判断

单 Agent 一把梭会失败——任务太杂、报错无法定位、产物不可复用。拆细 + 定契约是唯一能让链路可维护的做法。这也正是 Agent 编排类产品的核心设计难点:边界怎么切、失败怎么回滚、中间产物怎么被下一个环节消费。

结果

平台已上线并开源。配套 NeuroViz 前端把 EEG 频段与状态可视化,让「数据是否可用」这件事在界面上可判断,而不是等模型训练完才知道。
多 Agent 编排任务契约失败重试 EEG 信号处理Python
开放平台 · 开发者全链路

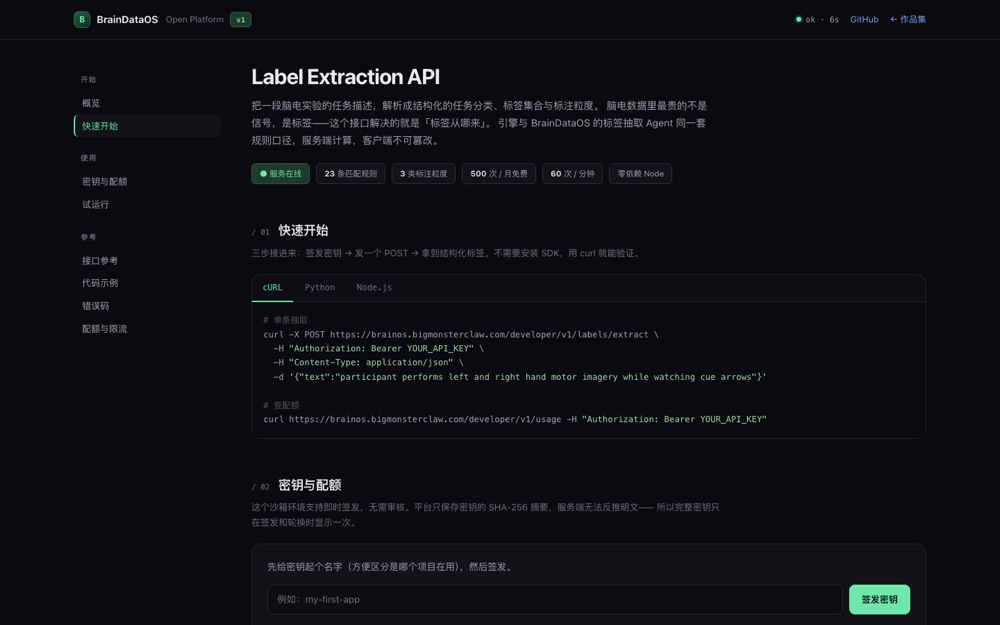
BrainDataOS Open Platform · 标签抽取开放接口

brainos.bigmonsterclaw.com/developer
● 在线可用
BrainDataOS 开放平台开发者控制台截图
背景

BrainDataOS 里的标签抽取能力原本只是一条命令行脚本——只有我自己能用。要验证「平台产品」这件事,光有内部能力不够,得让外部开发者能接进来。

我做了什么

把 Agent 的规则引擎抽成 HTTP 接口,补齐一个开放平台该有的全部外围:密钥签发 / 轮换 / 吊销、月度配额与分钟级限流、统一错误码与 request_id、OpenAPI 机器可读描述,以及一个能当场跑通的控制台。零依赖 Node 实现,systemd 常驻,挂在自有域名与证书下。

关键问题与判断

三处判断决定了这个产品能不能立住:密钥只存 SHA-256 摘要(明文落库=一次泄露即批量盗用);配额与限流拆成两套阈值(配额防长期占用,限流防瞬时打爆);响应里带回 confidence 与 alternatives(一段描述常同时含多个范式,假装 100% 准确比承认不确定更危险)。

结果

线上可访问,任何人可当场签发密钥、调通第一个请求、看到配额实时扣减。23 条规则、三类标注粒度(trial / epoch / subject)全部可通过 /v1/rules 审计。

开放平台设计API 契约密钥治理 配额与限流OpenAPINode.js / systemd / Nginx
模型训练 · 人格与记忆机制

16 型人格交互模型 · 本地自训练

私有部署 · 本地推理
● 本地运行
LOCAL INFERENCE · NO EXTERNAL API
16 型人格 · 本地交互模型
私有部署,数据不出本机。可面试现场演示,故不公开截图。
背景

通用大模型回答「像 AI」,不像一个具体的人。要让 16 种人格各自成立——同一句话由不同人格说出来,语气、价值判断、决策倾向都应该不同——靠一条系统提示词是做不到的。

我做了什么

本地部署 1.5B 级开源小模型(GGUF 4-bit 量化、32K 上下文、支持工具调用),在其上训练 16 型人格的交互层:为每种人格定义稳定的语言风格、价值倾向与反应模式,并设计多轮对话中的记忆写入与召回规则。

关键问题与判断

最难的不是「像」,是持续像。对话轮次一多,人格会被上下文稀释、被用户带跑。所以真正的工作量在上下文管理——哪些进记忆、哪些只留在当前轮、什么时候该重申人格锚点。这和小参数模型的能力边界也是强相关的:能力不够时,人格反而更容易崩。

结果

可在本地离线运行,16 种人格在同一基座上保持可区分的行为差异,多轮对话中人格漂移可控。全程无外部 API 依赖,数据不出本机。

本地小模型人格一致性上下文管理 记忆写入与召回4-bit 量化离线推理
私有部署,可面试现场演示
AI 应用 · 降低使用门槛

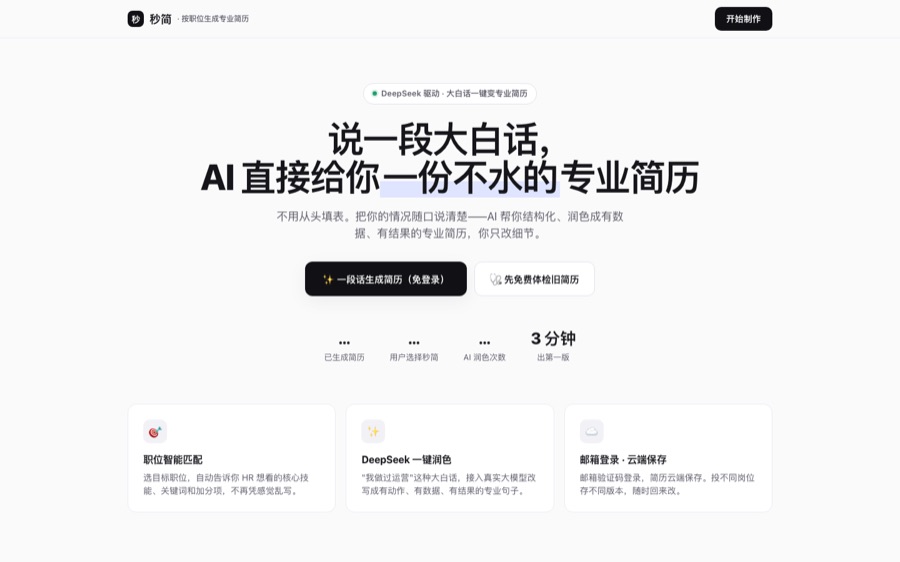
秒简 · AI 简历生成器

cv.bigmonsterclaw.com
● 在线
秒简 AI 简历生成器界面截图
背景

求职者不会写简历——经历描述口语化、缺少岗位关键词、排版杂乱,在 ATS 筛选阶段就被过滤。市面工具大多要求用户先学会「怎么提问」。

我做了什么

把「写简历」重构成三步:大白话填经历 → 按目标职位改写润色 → 一键导出 A4 PDF。用户不需要写提示词,结构约束和关键词匹配全部由产品在背后完成。

关键问题与判断

LLM 输出不稳定,直接生成会跑偏、每次结果都不一样。用结构化字段回填 + 职位关键词约束把自由度收窄,让输出可预期、可编辑。AI 产品的体验好坏,往往取决于你把「不确定」藏得多好。

结果

已上线,30 秒免费体检 + PDF 即投即用,形成完整可用闭环。

LLM 产品化提示词工程结构化输出约束 Next.jsPDF 生成
跨团队落地 · 数据驱动

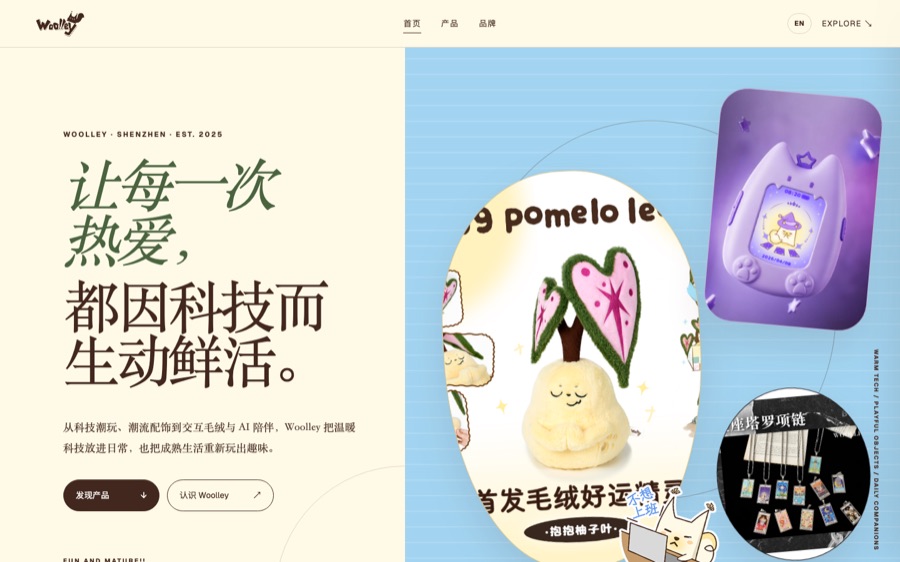
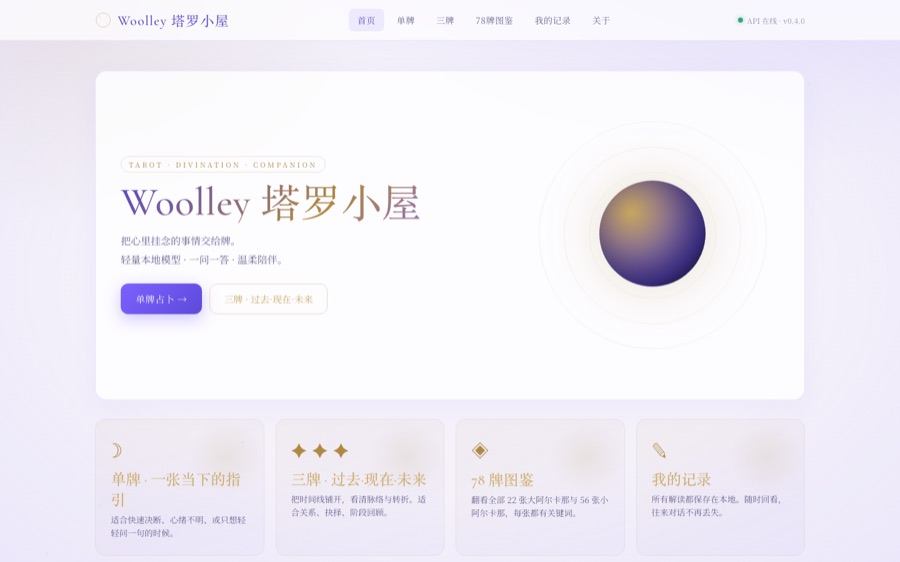
Woolley 品牌矩阵与运营数据体系

woolleygoods.com
● 在线
Woolley 品牌官网界面截图
背景

文创 / 潮玩品牌的线上阵地割裂:官网、内容触点、用户互动各做各的,无法形成品牌记忆,也看不到投入产出。

我做了什么

搭一套矩阵:品牌官网承载产品线与叙事,塔罗小屋做轻互动拉新,配合电商与社媒承接转化;同时建立抖音 / 天猫的月度 GMV 与内容表现追踪。

关键问题与判断

小团队没有设计资源——用统一视觉语言 + 组件化页面,让多个站点既一致又能快速上线。数据这块的难点是口径:先定清楚看什么指标、怎么归因,再谈优化,否则看板只会变成装饰。

结果

官网 + 互动应用双站上线,运营数据按月复盘,指导内容与选品方向。

品牌策略官网设计vinext / React Cloudflare Worker运营数据体系
02 — MINI PROGRAMS

已上线小程序

微信生态内的轻量 AI 应用,可直接在微信中打开体验。

色
● 微信已上线

色彩测试

个人色彩季型测试。用一组视觉选择题判断用户色彩倾向,输出专属配色建议与穿搭色系——把「审美」这件主观的事做成可复用的判断流程。

#小程序://色彩测试/9JMdWsTOMt3j9Ua
复制上方口令,在微信任意聊天窗口粘贴即可打开
AI
● 微信已上线

AI 小白助手

面向非技术用户的 AI 入门助手。用日常语言解答 AI 使用问题、推荐合适工具与提示词写法,核心目标是持续降低普通人理解 AI 的门槛。

#小程序://AI小白助手/Tb9sQzc2RGuQjmC
复制上方口令,在微信任意聊天窗口粘贴即可打开
03 — CAPABILITIES

AI 能力与工程底子

每一项都有对应产出,可以现场追问细节。

Agent 编排

多 Agent 任务拆解、输入输出契约设计、失败重试与中间产物管理。实做 6 Agent 协作流水线。

模型训练与推理

本地部署开源小模型、量化(GGUF 4-bit)、人格化交互训练、离线私有推理。

上下文与记忆

多轮对话的记忆写入 / 召回策略,人格锚点维持,长对话下的信息优先级取舍。

工具调用与 Skills

Function Calling 接入、工具描述设计、调用失败兜底;自建模型网关管理多供应商接入与密钥。

开放平台治理

密钥签发 / 轮换 / 吊销、摘要存储、月度配额与分钟限流双阈值、统一错误码与 request_id 追踪。已上线可调用。

接口与文档设计

RESTful 契约、批量与单条的成本折算、OpenAPI 机器可读描述、开发者从接入到调通的最短路径设计。

效果评估

为功能设定可验证口径(准确率、人工复核耗时、信号命中率),而不是用主观满意度收尾。

全链路工程

Node / Python 后端,Nginx、TLS、Docker、三台云服务器运维,从代码到上线自己走完。

04 — ALL PROJECTS

其余在线项目

教育工具、数据工具、品牌互动与个人项目,均已真实部署、逐个实测可访问。